
IT-drift
& Service
Vi overvåger, vedligeholder og retter jeres IT 24/7/365, så jeres team kan fokusere på at udvikle forretningen. Leveres under en kontraktlig SLA.
Tre driftsdomæner
Én driftspartner, tre klare ansvarsområder
Vi organiserer 24/7-driften i tre domæner, så det altid er klart, hvem der har ansvaret for sikkerhed, infrastruktur og applikationernes pålidelighed.
- SOC
Sikkerhed
Vi overvåger sikkerhedshændelser (SIEM/XDR), vurderer trusler, reagerer på hændelser og lukker kendte sårbarheder med sikkerhedspatches.
Relaterede ydelser
- NOC
Netværks- og cloudinfrastruktur
Vi overvåger netværk, servere og cloudtjenester 24/7/365, løser hændelser inden for SLA'en og eskalerer dem til den rette ingeniør.
Relaterede ydelser
- SRE
Applikationspålidelighed
Vi måler tjenesternes tilgængelighed mod SLO'er, styrer fejlbudgetter, tester gendannelse og analyserer årsager, så forretningskritiske applikationer forbliver tilgængelige.
Relaterede ydelser
Vores driftsprocesser er inspireret af NATO's disciplin og metodik og tilpasset kravene i forretningskritiske IT-miljøer.
Vores ansvar
Vi tager ansvaret for jeres daglige IT
Drift er mere end at reparere det, der går i stykker. Vi overvåger, analyserer og forbedrer løbende jeres systemer, så de kører stabilt og sikkert. Vores NOC og SOC gennemløber denne cyklus hver dag, døgnet rundt, med kontraktligt ansvar:
- 01
Vi ser
Vi overvåger jeres systemer 24/7 og opdager problemer før jeres kunder.
- 02
Vi forstår
Vi filtrerer støjen fra og finder årsagen og konsekvensen for forretningen.
- 03
Vi handler
Vi løser hændelser inden for SLA'en, også om natten og i weekenden.
- 04
Vi forbedrer
Vi gør hver hændelse til en forbedring, så den ikke gentager sig.
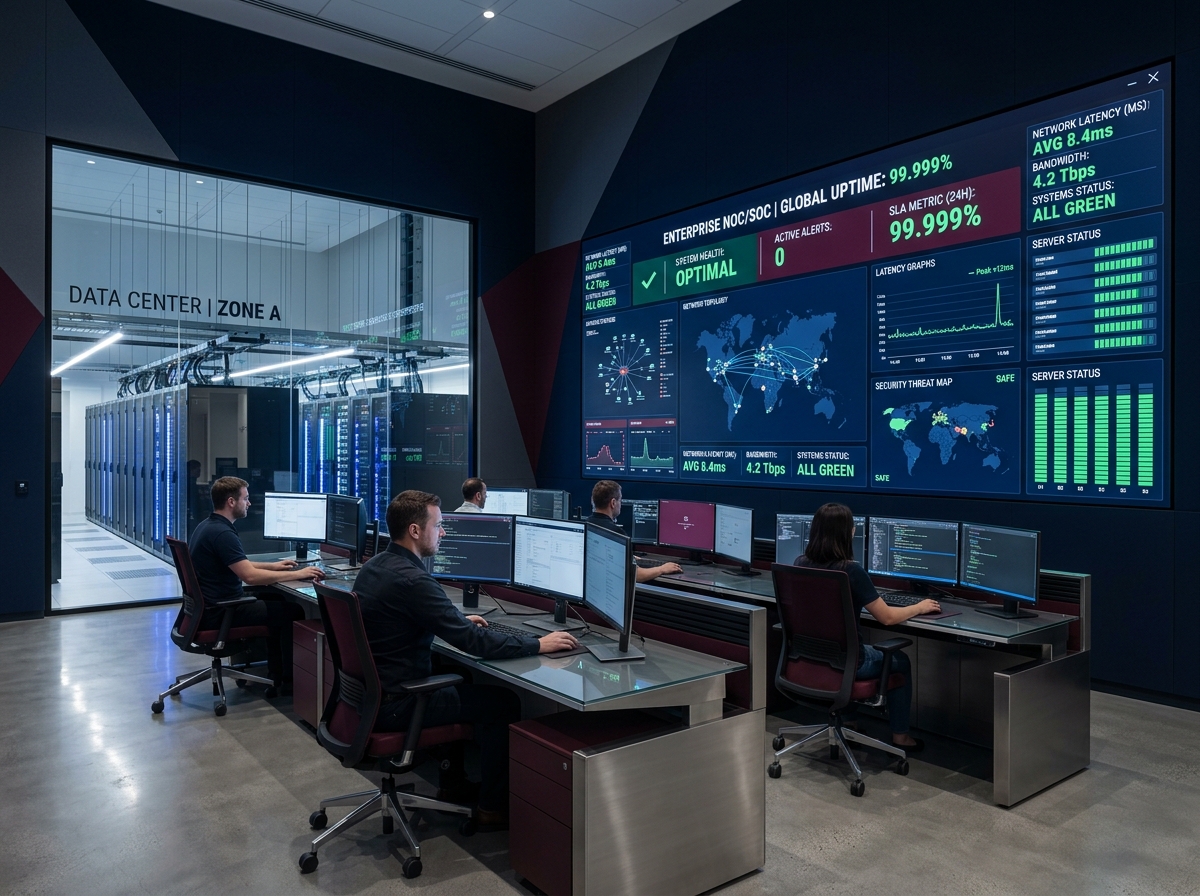
Sådan ser vi
I hører om et problem fra os, ikke fra jeres kunder. Vores NOC og SOC overvåger jeres systemer døgnet rundt og opdager afvigelser, før de bliver til hændelser.
- Overvågning af systemer, netværk og tjenester 24/7/365
- Overvågning af sikkerhedshændelser (SIEM/XDR)
- Måling af tjenesternes tilgængelighed mod SLO'er og SLA'er
- Månedlige rapporter med telemetridata og SLA-opfyldelse
Sådan forstår vi
Ikke enhver alarm er en hændelse. Vores ingeniører filtrerer støjen fra, finder årsagen og forstår konsekvensen for forretningen.
- Korrelation af alarmer og støjfiltrering
- Prioritering af hændelser efter forretningsmæssig konsekvens
- Årsagsanalyse frem for symptombehandling
- Vurdering af sikkerhedstrusler i SOC'en
Sådan handler vi
Når noget sker, handler vi inden for SLA'en i stedet for at vente på, at arbejdsdagen begynder.
- P1-respons inden for 15 minutter på Mission Critical-niveau
- En dedikeret nødlinje direkte til ingeniører
- Sikkerhedspatches og udbedring af sårbarheder
- Gendannelse af data inden for aftalt RTO og RPO
Sådan forbedrer vi
Hver hændelse er en lektie. Vi analyserer årsagerne og indfører ændringer, så det ikke sker igen.
- Årsagsanalyse (RCA) inden for 24 timer
- Fejlbudgetter og SLO-styring
- Regelmæssige audits af cyberhygiejne og compliance
- En månedlig plan for forbedring af ydelsen
Erfaring i praksis
Kontraktuelle SLA-niveauer & responsparametre
Standard Business
8/5- Responstid: < 2 timer (P1)
- Hverdage: 08:00 - 18:00
- Regelmæssige systemaudits
Enterprise 24/7
24/7- Responstid: < 30 minutter (P1)
- 24/7/365 NOC-overvågning
- Dedikeret telefonlinje
Mission Critical
HØJESTE NIVEAU- Responstid: < 15 minutter (P1)
- Dobbelt NOC & SOC i 3 skift
- Servicekreditter i henhold til kontraktvilkårene
Fra vores projekterfaring
Ofte stillede spørgsmål
Hvor hurtigt reagerer I på en hændelse?
På Mission Critical-niveau inden for 15 minutter ved P1-hændelser, 24/7/365.
Hvad indeholder SLA'en?
Responstider, overvågning, løsning af hændelser og løbende rapportering. I vælger niveau efter, hvor kritisk systemet er.
Driver I også systemer fra andre leverandører?
Ja. Overtagelsen starter med en audit og en oprydning i dokumentationen.
Hvordan kan vi følge kvaliteten af ydelsen?
I månedlige rapporter med telemetridata og SLA-opfyldelse.